Nala AI Runtime Architecture: Genkit, tool orchestration y safety-by-design.
Nala no está planteado como una simple llamada a un modelo. La parte interesante del proyecto es la arquitectura que rodea al LLM: un runtime propio que prepara el contexto, aplica seguridad, controla herramientas, ejecuta Genkit, valida la salida, actualiza memoria y deja trazabilidad.
Esto es importante porque una demo de IA puede vivir con un prompt grande y una llamada directa al SDK. Un producto real no. En cuanto aparecen memoria, reglas familiares, streaming, señales parentales, herramientas y seguridad, necesitas fronteras claras.
1. El problema de arquitectura
Una integración inicial de IA suele empezar con algo parecido a esto:
const response = await openai.chat.completions.create(...)
Eso sirve para validar una idea, pero no responde preguntas de producto:
- dónde vive el contexto de conversación;
- cómo se aplican reglas familiares;
- cómo se tratan mensajes sensibles;
- qué herramientas puede usar el modelo;
- cómo se evita que una tool use un adapter incorrecto;
- cómo se persiste memoria sin guardar datos peligrosos;
- cómo se depura una respuesta mala;
- cómo se hace streaming sin duplicar toda la lógica.
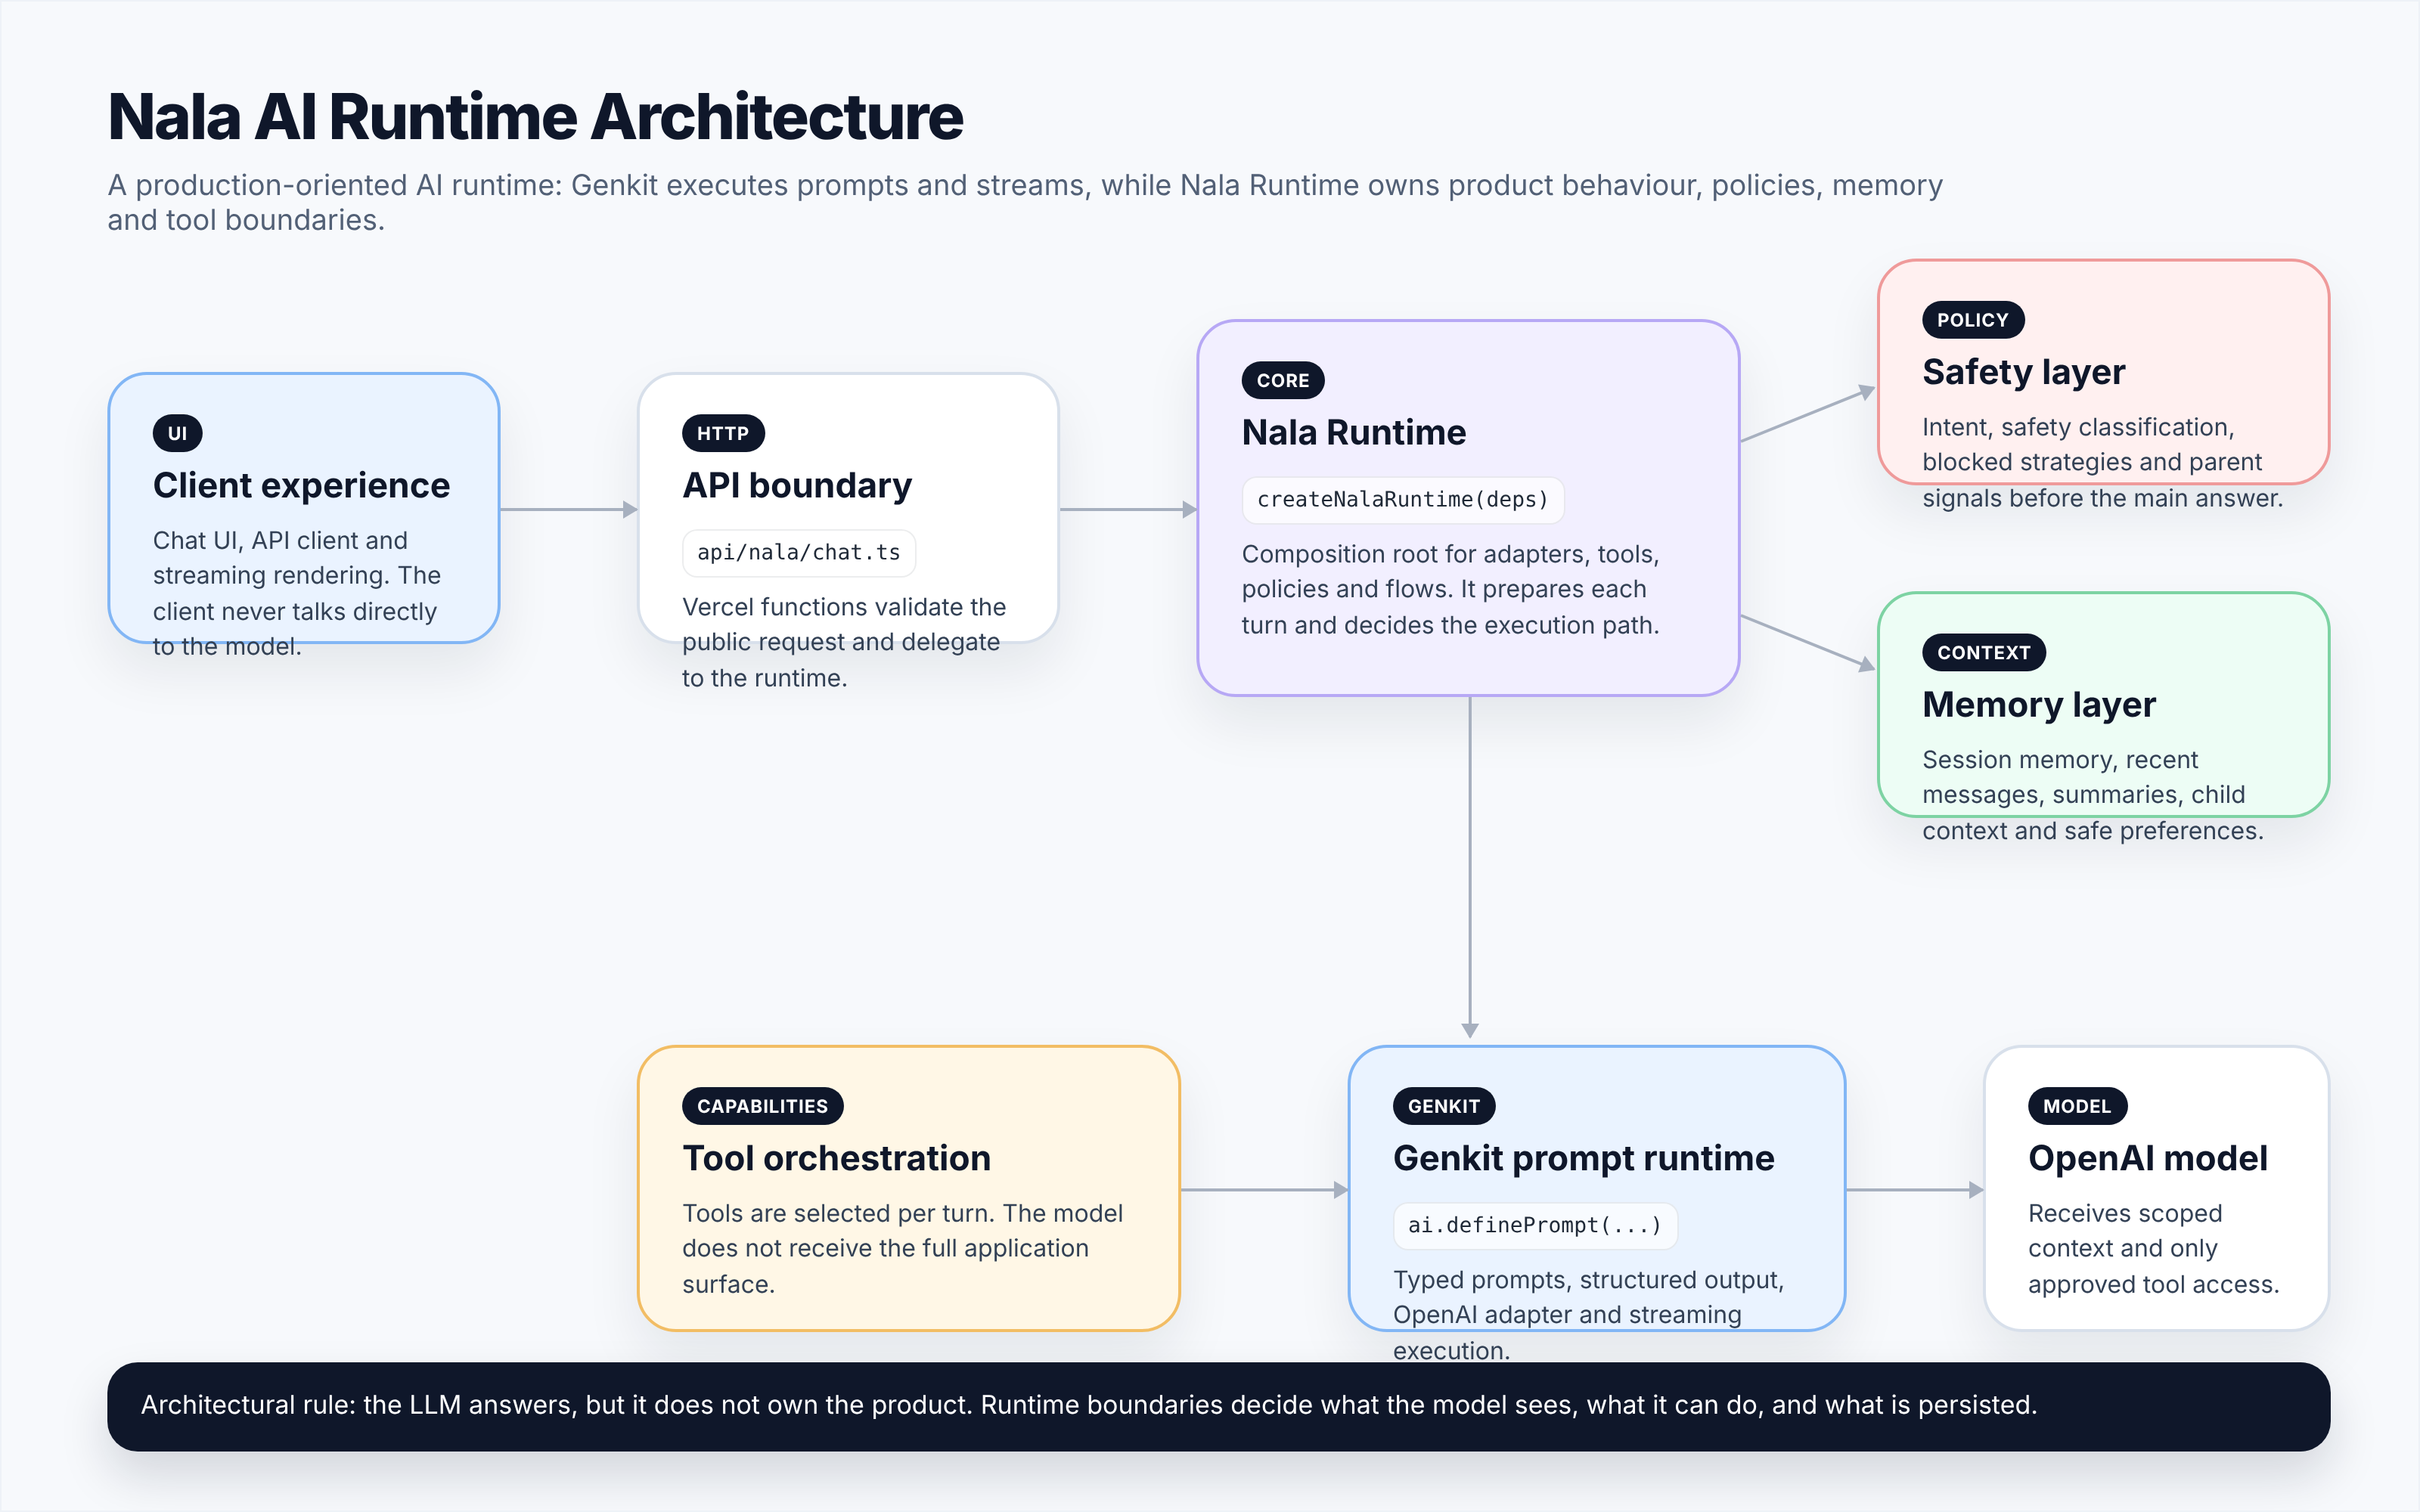
Nala separa esas responsabilidades en capas. La API adapta HTTP. El runtime gobierna la ejecución. Genkit orquesta prompts y modelo. Los adapters encapsulan persistencia y contexto. Las policies controlan safety, memoria y tools.
2. API boundary
Los endpoints principales están en:
api/nala/chat.ts
api/nala/stream.ts
Su responsabilidad es deliberadamente pequeña: recibir la petición, validar el contrato público, construir el input interno y delegar en el runtime.
El endpoint normal acaba en:
defaultNalaRuntime.runChatFlow(...)
El endpoint de streaming acaba en:
defaultNalaRuntime.runChatStreamFlow(...)
La diferencia entre ambos está en la entrega de la respuesta, no en el modelo mental de ejecución.
3. Runtime composition
El centro está en src/runtime.ts:
createNalaRuntime(deps)
Esta función crea un runtime con dependencias explícitas:
- adapters;
- tools construidas sobre esos adapters;
- servicios internos;
- flag
allowLlmToolUse;
- flujos
runChatFlow y runChatStreamFlow.
La decisión es buena porque evita que todo dependa de singletons globales. Un runtime aislado puede usar adapters inyectados y mantener garantías claras en tests, entornos separados o futuras configuraciones multi-tenant.
El runtime por defecto usa inMemoryNalaContextAdapter y activa allowLlmToolUse: true para Developer UI y flujos globales. Los runtimes custom, en cambio, tienen allowLlmToolUse a false por defecto.
4. Secuencia real de ejecución
El flujo de un turno no es “prompt → modelo → respuesta”. Es una pipeline.
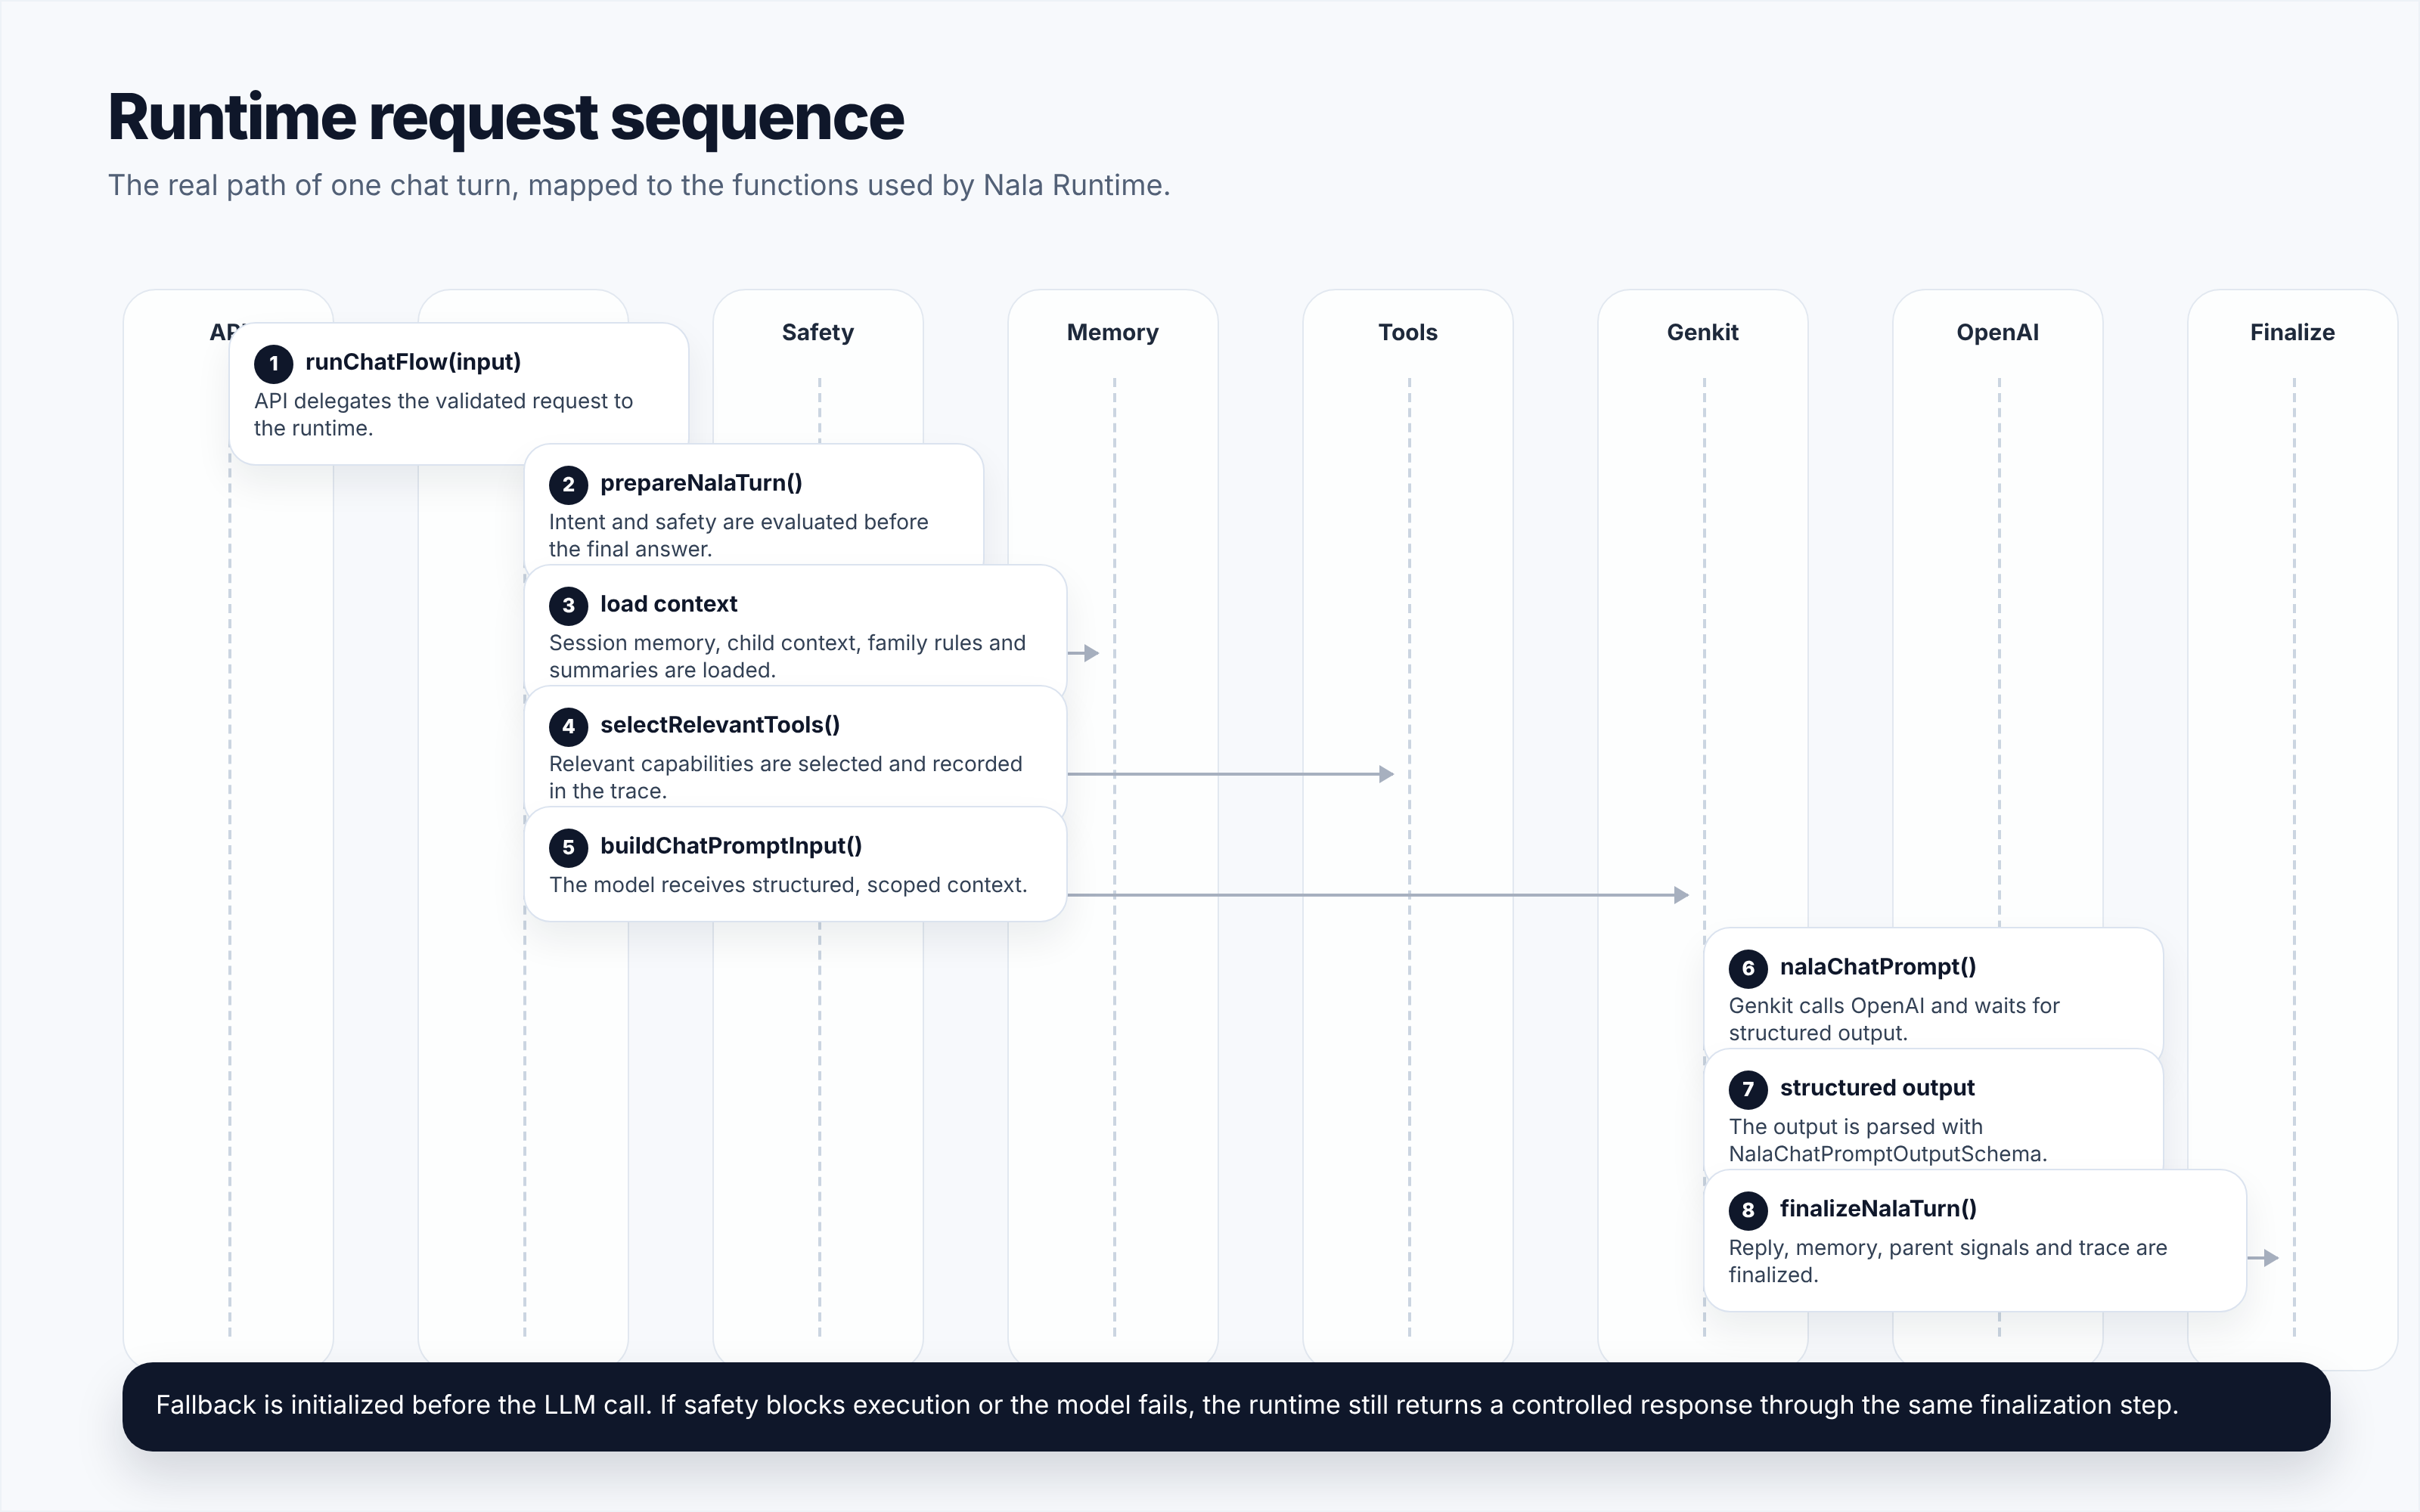
Los pasos principales son:
const trace = createTrace('nalaChatFlow', input.metadata?.traceId)
const prepared = await prepareNalaTurn(input, trace, services)
const promptInput = buildChatPromptInput(input, prepared)
const relevantTools = selectRelevantTools(input, prepared, services)
const fallback = fallbackPromptOutput(input, prepared)
const { skip, reason } = shouldSkipChatLlm(prepared)
Después, si no se salta el LLM, se ejecuta:
const response = await nalaChatPrompt(promptInput, {
  tools: relevantTools.actions,
  maxTurns: 3,
  returnToolRequests: true,
})
Y finalmente:
return finalizeNalaTurn({ input, prepared, promptOutput, trace, services })
La parte importante es que el fallback se prepara antes de llamar al modelo. Si el LLM falla o si safety recomienda no usarlo, el sistema puede responder de forma controlada.
5. Genkit dentro de Nala
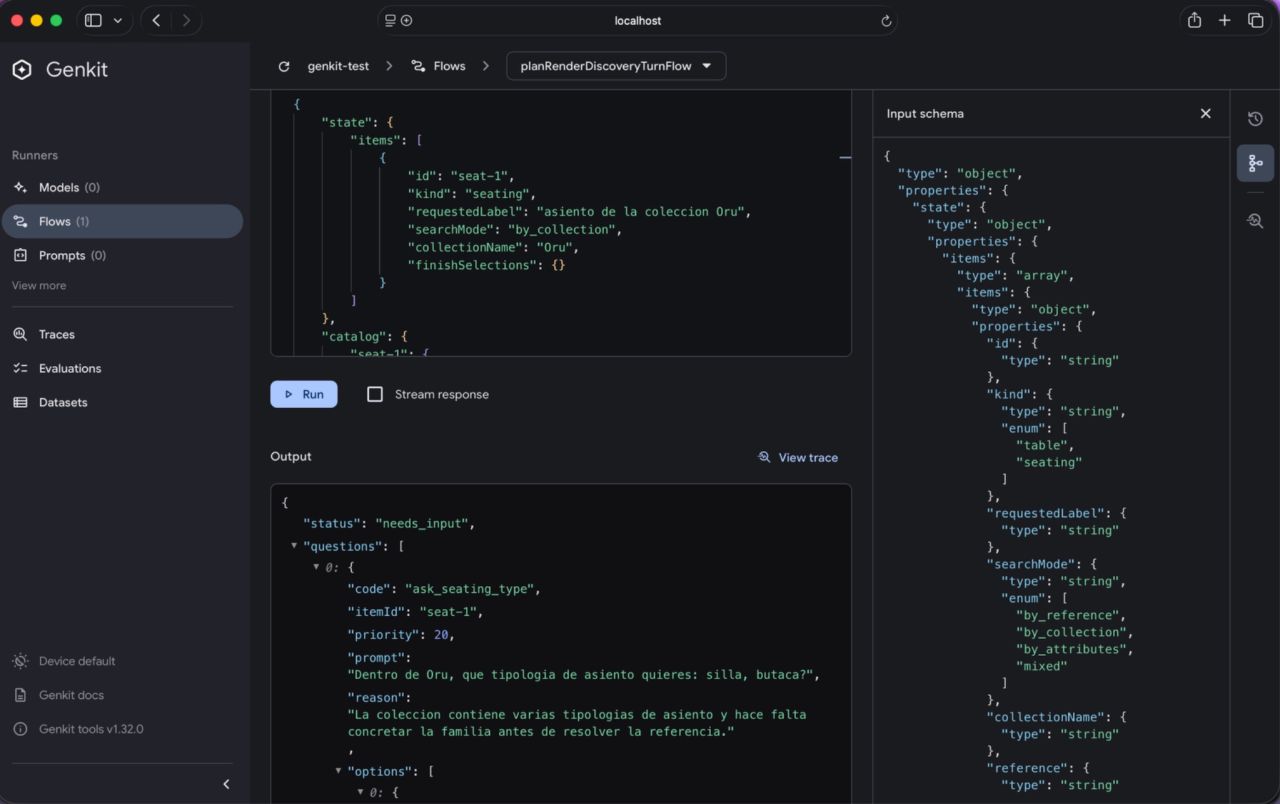
Genkit se inicializa en src/genkit.ts:
export const ai = genkit({
  name: 'nala-ai-api',
  plugins: [openAI()],
  model: `openai/${resolveNalaModelName()}`,
})
En Nala, Genkit aporta:
definePrompt;- schemas de entrada y salida;
- abstracción del proveedor;
- streaming;
- integración de tools.
Pero Genkit no contiene toda la lógica de negocio. La arquitectura queda más sana si Genkit se usa como capa de ejecución IA y el runtime conserva las decisiones de producto.
6. Contracts-first
Los contratos están en src/contracts/nala.contracts.ts.
Algunos schemas clave:
NalaChatInputSchema;NalaChatPromptInputSchema;NalaChatPromptOutputSchema;NalaChatOutputSchema;NalaSafetyOutputSchema;NalaIntentOutputSchema;NalaSessionUpdateSchema.
Esto reduce ambigüedad. La API no recibe cualquier cosa. El prompt no consume un objeto improvisado. La respuesta final no sale al cliente sin validación.
En IA esto importa especialmente porque el modelo puede fallar de formas raras. Los contratos reducen el radio de impacto.
7. Control plane alrededor del modelo
La forma correcta de mirar Nala es como un control plane alrededor del LLM.
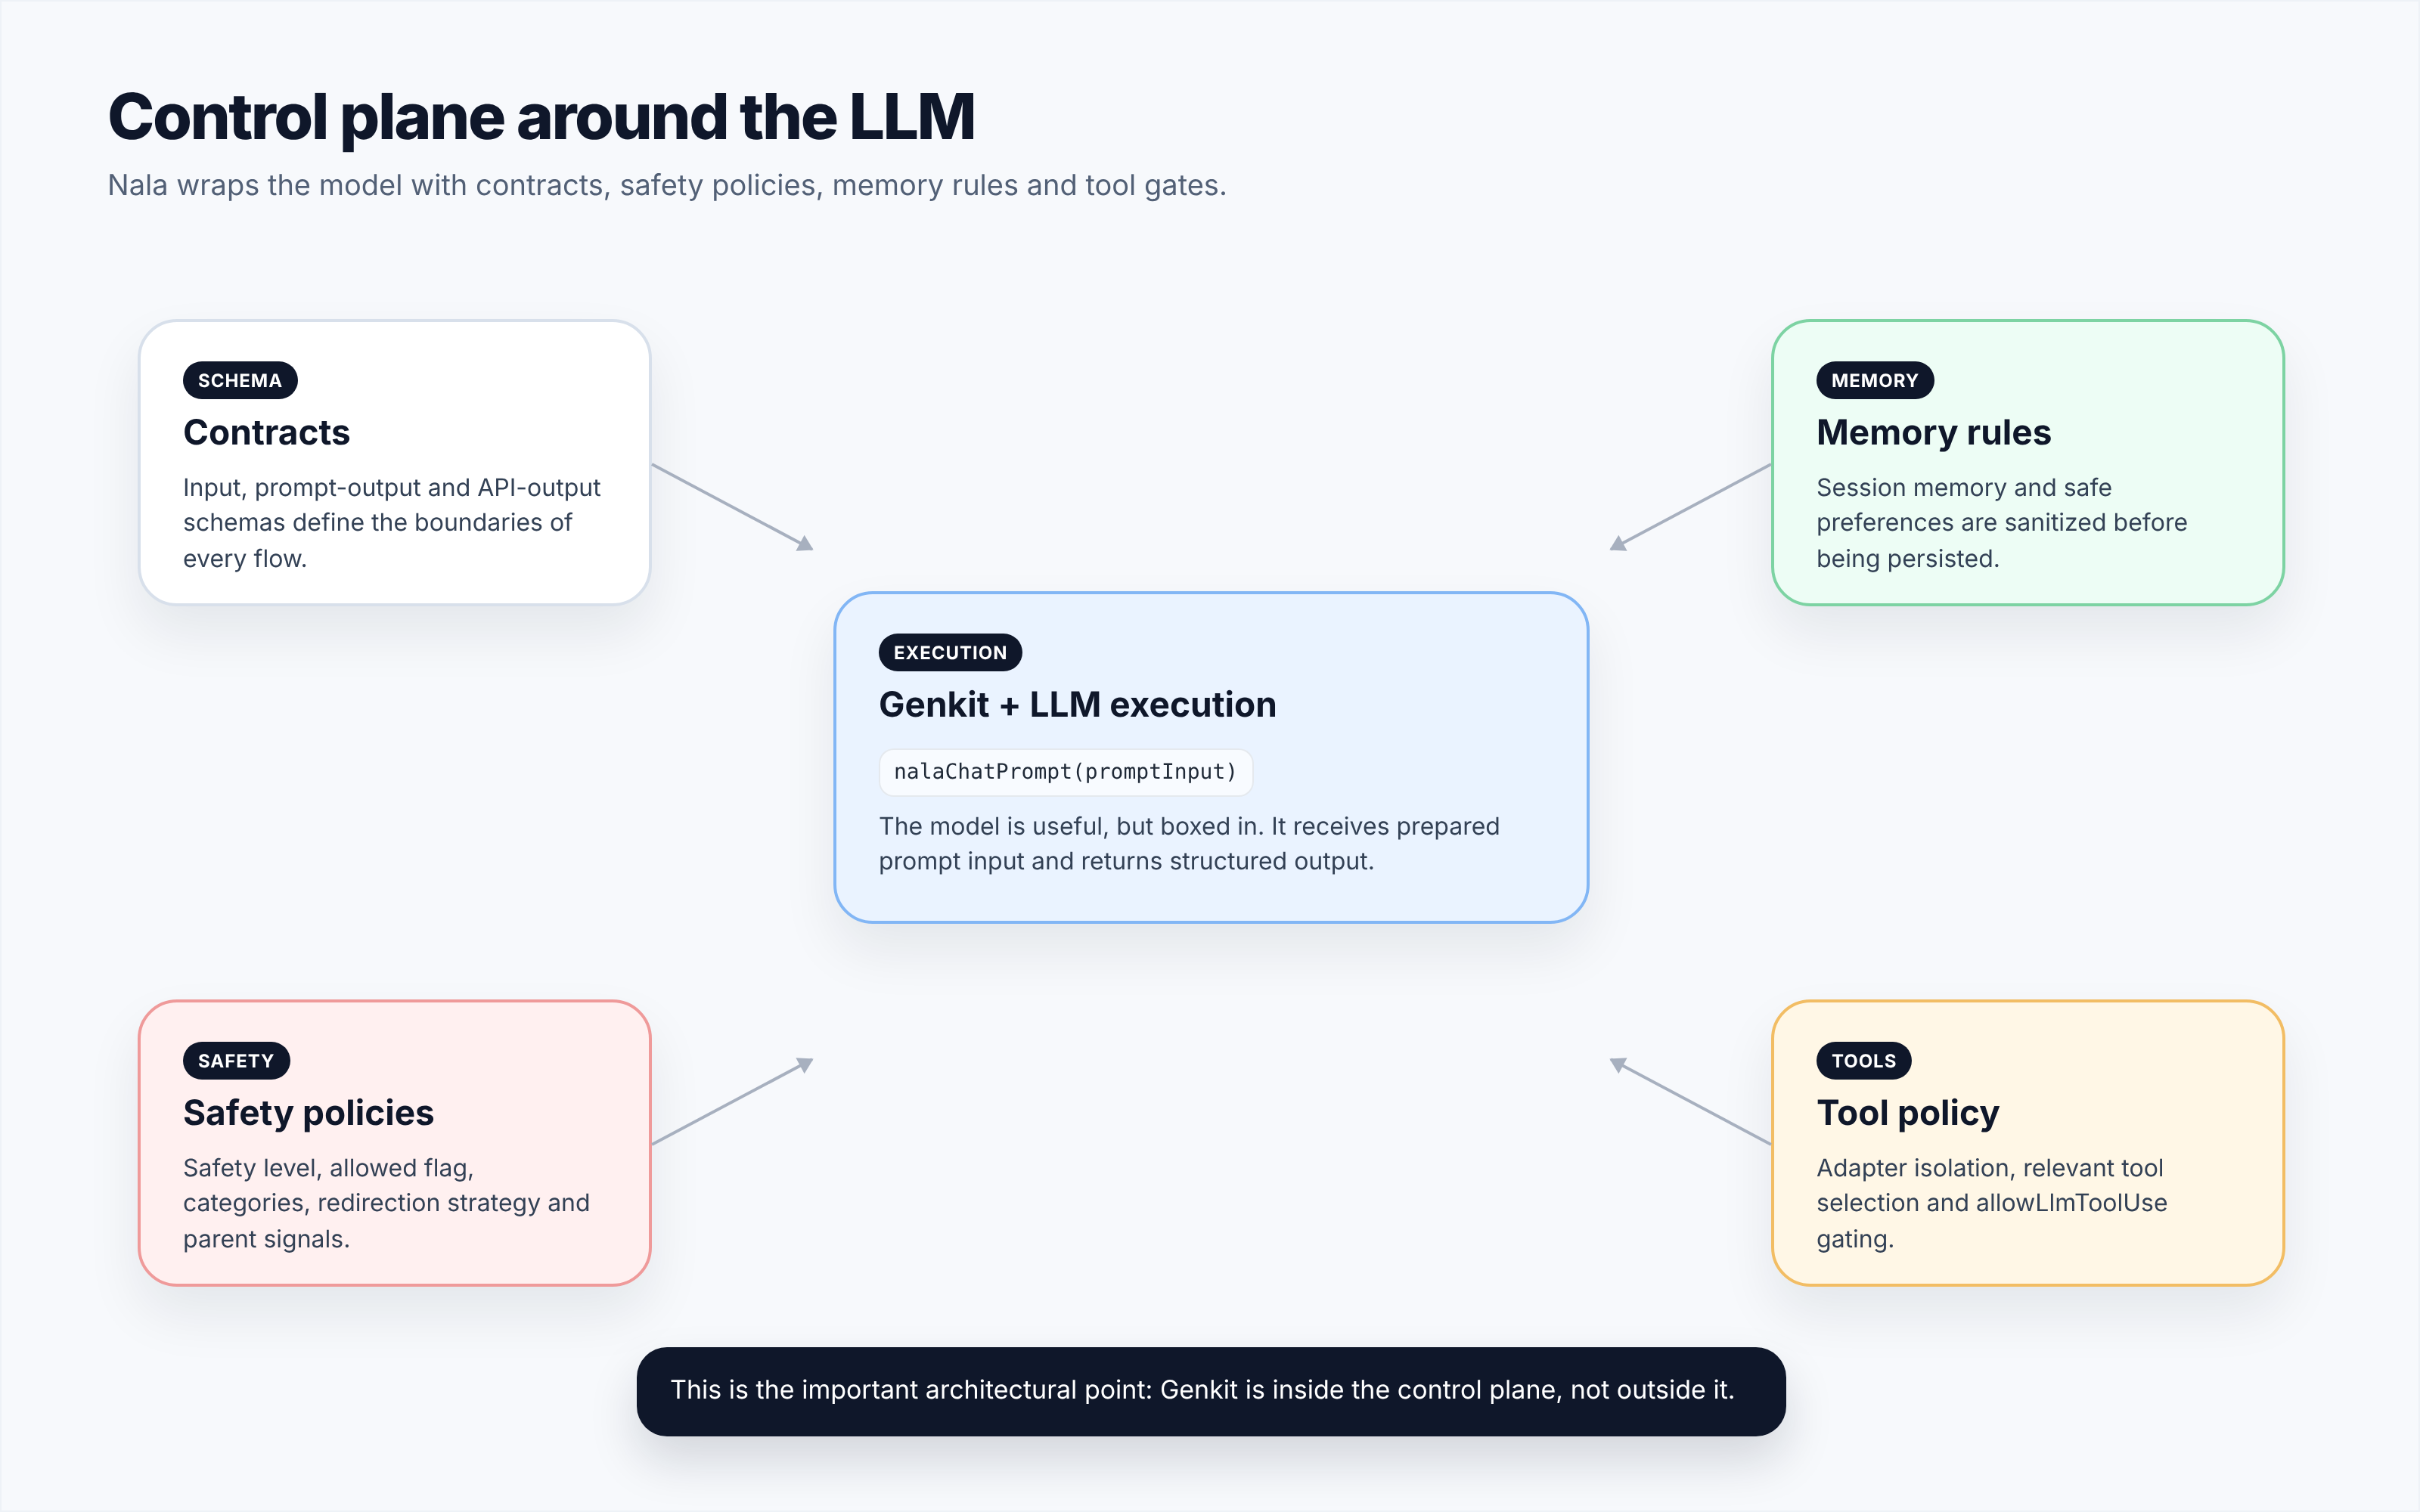
El modelo está rodeado por cuatro fronteras:
- contratos;
- políticas de seguridad;
- reglas de memoria;
- política de herramientas.
El LLM responde, pero no decide por sí solo qué contexto ve, qué herramientas usa o qué se guarda.
8. Tool orchestration
El tool calling es una de las partes más delicadas de cualquier arquitectura con LLM.
Nala separa dos conceptos:
createNalaTools(adapters)
crea herramientas internas cerradas sobre adapters inyectados.
Y por otro lado están las tools de Genkit declaradas con ai.defineTool.
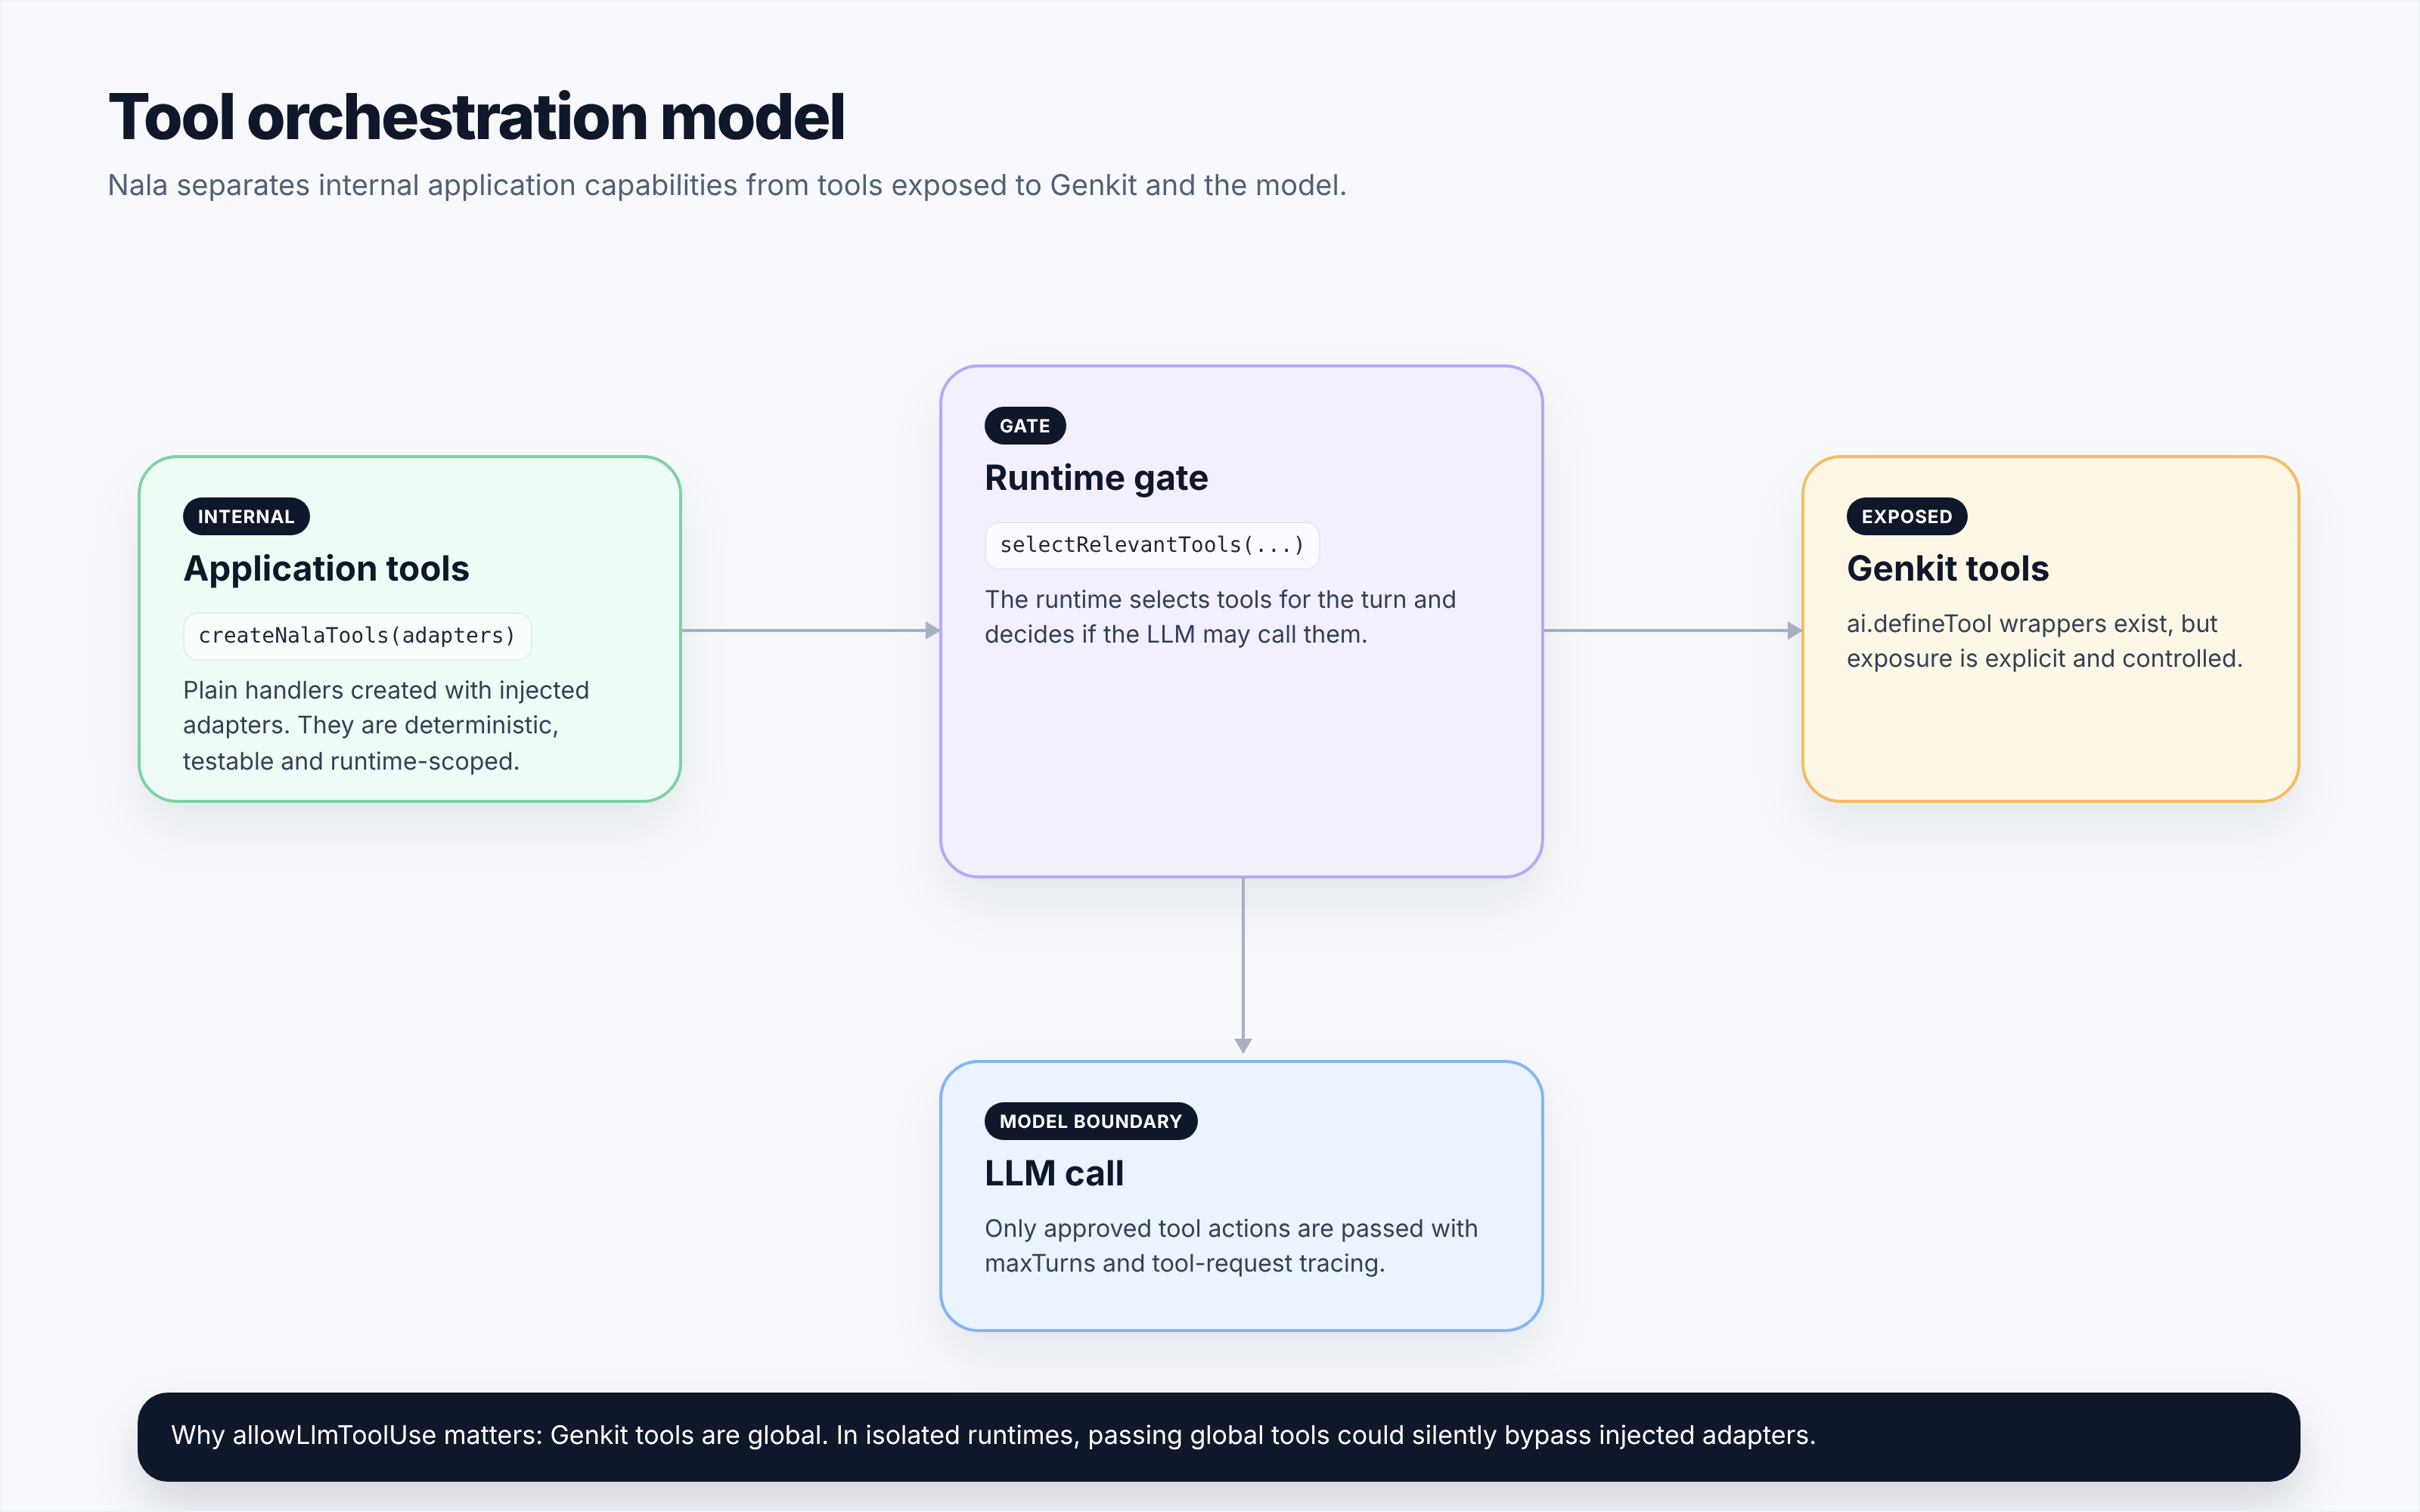
La selección por turno se hace con:
selectRelevantTools(input, prepared, services)
Además, allowLlmToolUse controla si las acciones se pasan realmente al modelo.
Este detalle evita un problema sutil: las tools de Genkit son globales. Si se pasan a un runtime aislado sin cuidado, pueden acabar usando adapters globales en lugar de los adapters inyectados. Por eso el runtime custom no permite LLM tool use por defecto.
9. Safety-by-design
Safety no debería ser solo una línea dentro del prompt. En Nala es una parte de la ejecución.
prepareNalaTurn integra intención, safety, memoria y reglas familiares antes de construir el prompt final. El safety flow puede devolver información como:
safetyLevel;allowed;categories;blockedReason;redirectionStrategy;parentSignal.
Esto permite que el runtime decida si llama al LLM, si usa fallback o si registra una señal parental.
Para un asistente con contexto infantil/familiar, esa separación no es opcional. Privacidad, tono y límites son parte del producto.
10. Memory strategy
La memoria de Nala no intenta guardar todo.
La estrategia es mantener continuidad sin convertir la memoria en un contenedor peligroso:
- mensajes recientes limitados;
- resumen de sesión;
- preferencias seguras;
- sanitización antes de guardar;
- rechazo de datos sensibles;
- actualización al final del turno.
La memoria útil suele ser pequeña. Recordar “le gustan los dinosaurios” puede mejorar la experiencia. Guardar datos personales sensibles no.
11. Streaming
El streaming se implementa como variante del mismo runtime.
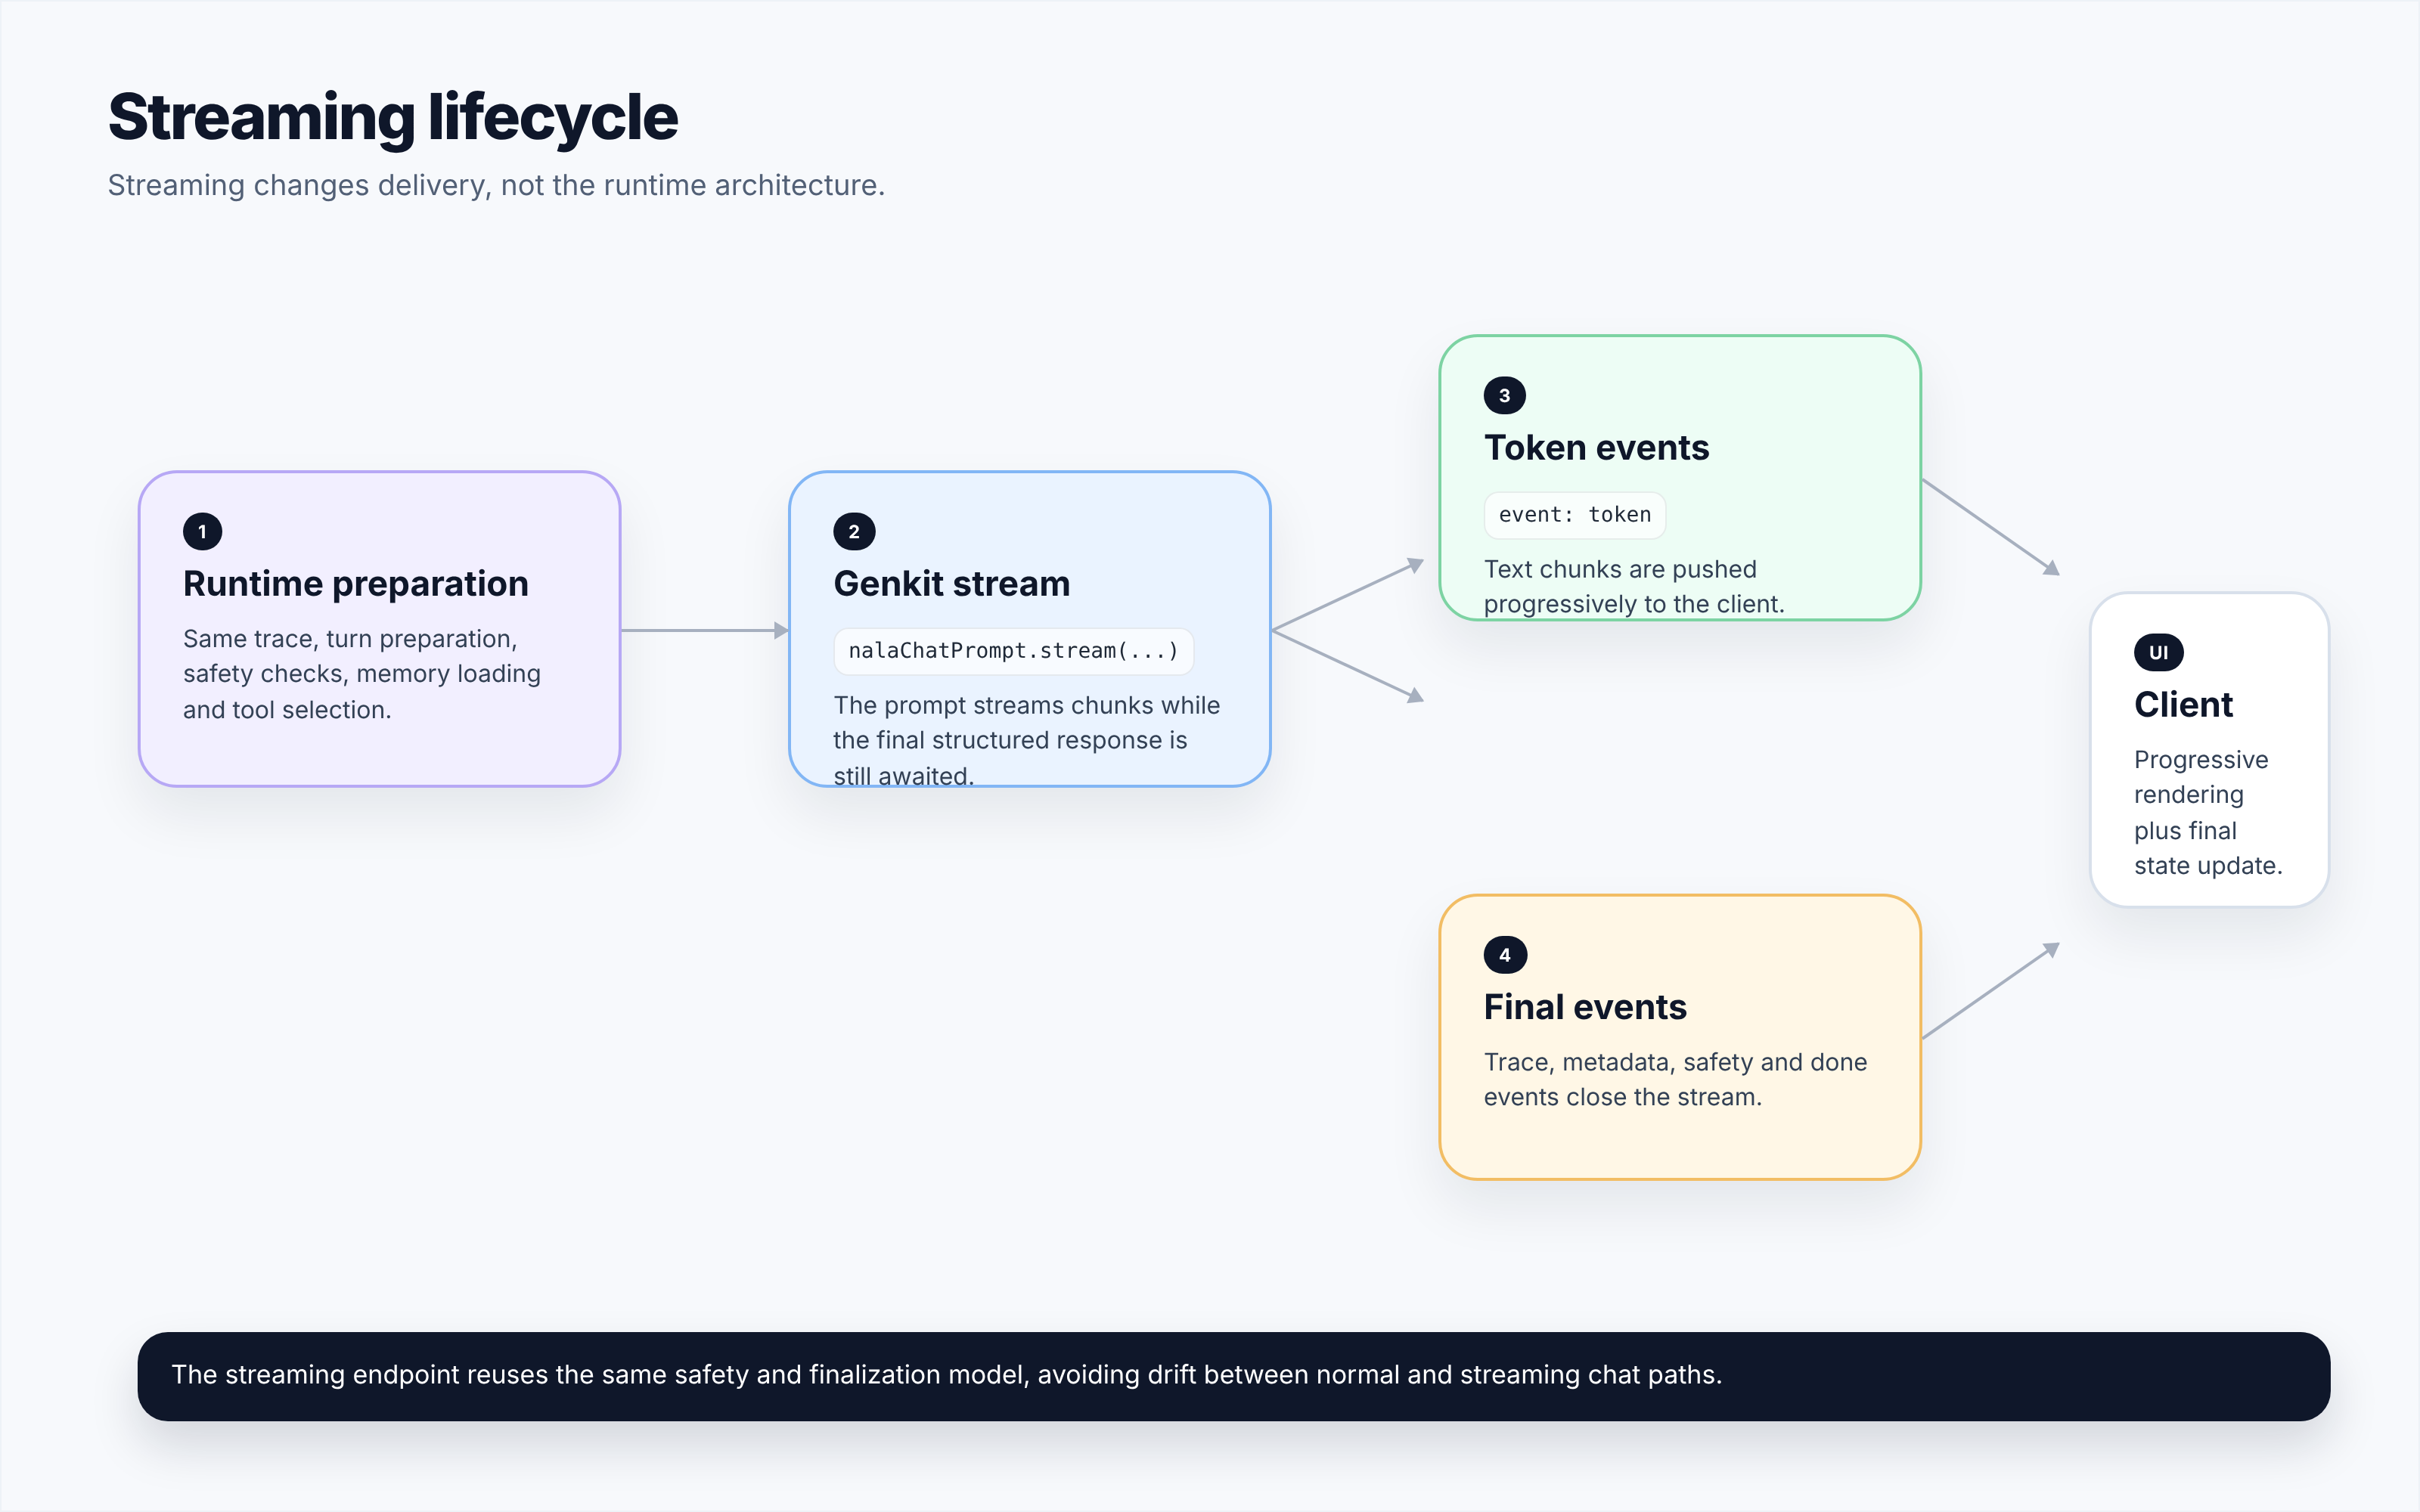
La ejecución llama a:
nalaChatPrompt.stream(promptInput, {
  tools: relevantTools.actions,
  maxTurns: 3,
  returnToolRequests: true,
})
Los chunks se emiten de forma progresiva y, al final, se espera la respuesta estructurada completa para validar y finalizar.
Esto evita crear una segunda arquitectura para streaming. La ruta normal y la ruta streaming comparten preparación, safety, tool selection, fallback y finalización.
12. Observability
Nala registra trazas con:
createTrace;addTraceStep;recordToolCall;completeTrace.
Esto permite saber qué intención se detectó, qué safety level salió, qué herramientas fueron seleccionadas, si hubo fallback y cómo terminó el turno.
En sistemas de IA, la observabilidad no es un extra. Sin trazas, depurar una mala respuesta es casi adivinar.
13. Testing y evals
El proyecto incluye tests y datasets de evaluación para áreas como:
- safety;
- privacidad;
- continuidad;
- estilo;
- juegos;
- family rules;
- memory;
- tools;
- runtime.
Esto es buena señal: una app de IA no se valida solo probando manualmente varias frases. Necesita regresión repetible.
14. Tradeoffs
La arquitectura gana control y testabilidad, pero añade más piezas:
- más contratos que mantener;
- más pasos en el runtime;
- más puntos de observabilidad;
- más disciplina al registrar tools;
- más cuidado con memoria y adapters.
Aun así, para un asistente sensible, ese coste es razonable. La alternativa —un prompt enorme con demasiadas responsabilidades— escala peor.
15. Próximas evoluciones
Las evoluciones naturales serían:
- adapter persistente con Redis o Postgres;
- versionado de prompts y policies;
- export de trazas a OpenTelemetry;
- panel de revisión de parent signals;
- capa RAG para conocimiento externo;
- evals automáticos con thresholds;
- separación más explícita entre runtime de producción y Developer UI.
Conclusión
Lo interesante de Nala no es solamente que use Genkit.
Lo interesante es cómo lo usa: Genkit vive dentro de un runtime que controla contexto, seguridad, memoria, herramientas, fallback, streaming y salida final.
Ese diseño es lo que diferencia una demo de chatbot de una base seria para un asistente de IA en producción.